01 三大基準全榜登頂,Thinker-WM 斬獲三項第一
02 Thinker-WM技術(shù)突破:表征層面實現(xiàn)視覺、幾何、動作多模態(tài)統(tǒng)一
03 3萬小時異構(gòu)數(shù)據(jù),讓一個模型,解鎖六種能力
04 3萬小時異構(gòu)數(shù)據(jù),撐起通用世界模型底座
05 數(shù)據(jù) Infra:讓海量異構(gòu)數(shù)據(jù)高效支撐統(tǒng)一模型訓練
項目鏈接
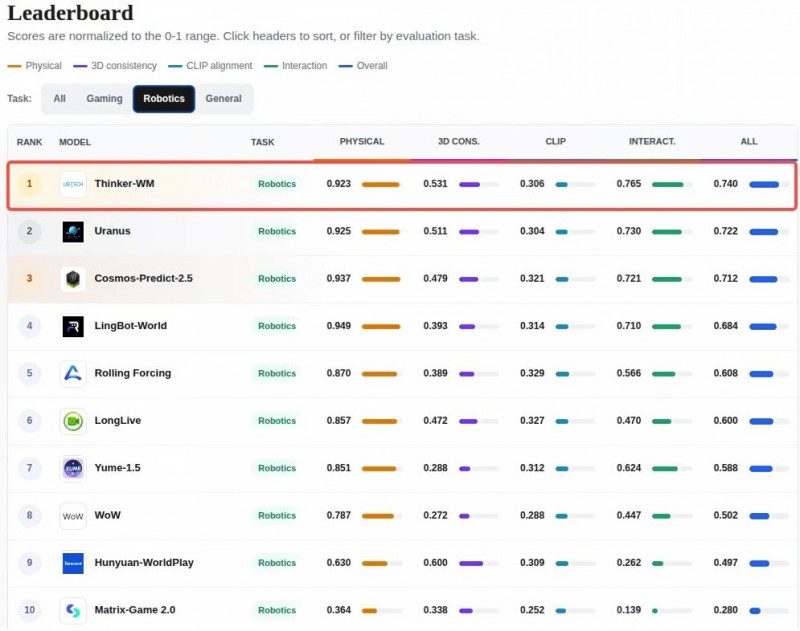
日前,優(yōu)必選 Thinker-WM在三大公認具身世界模型基準評測中全部拿下第一名,刷新行業(yè)成績:
WorldOlympiad:
Thinker?WM 取得綜合得分 0.740 位列榜首。該基準基于大量真實機器人交互數(shù)據(jù)構(gòu)建,覆蓋十余種不同機器人本體與多類相機配置,重點考核模型跨機器人形態(tài)、跨視角的泛化能力。模型取得 3D 一致性 0.531、交互保真度 0.765,兩項單項指標位居全部參評模型首位,體現(xiàn)模型對三維幾何結(jié)構(gòu)與機器人交互過程的精準建模能力。
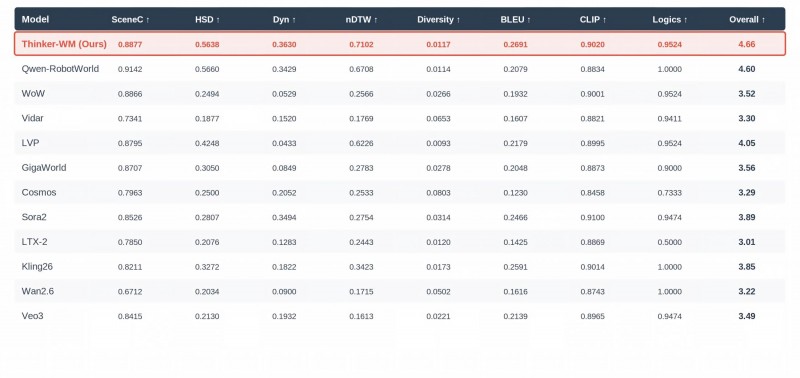
EWMBench:
Thinker?WM 取得綜合總分 4.66,超過 Qwen?RobotWorld、Sora2 等主流模型。EWMBench 完整考核場景一致性、機器人末端運動正確性、指令語義對齊三大能力維度。得益于表征層面的多模態(tài)聯(lián)合建模,Thinker?WM 在反映機器人軌跡時空匹配的 nDTW(歸一化動態(tài)時間規(guī)整)、表征運動速度與加速度合理性的 Dyn(動力學一致性)等機器人運動核心指標上實現(xiàn)領(lǐng)先。
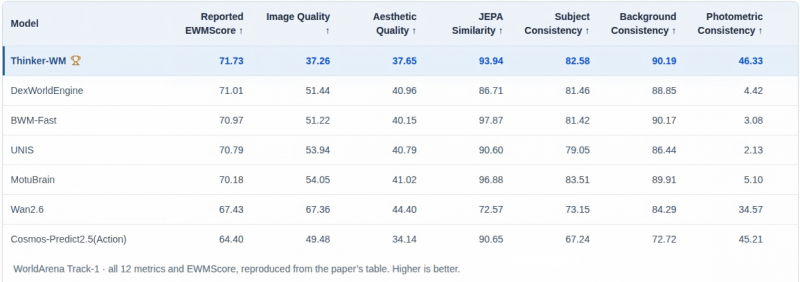
WorldArena1.0 Track-1:
在仿真環(huán)境基準 WorldArena Track?1,Thinker?WM 在視覺畫質(zhì)、內(nèi)容一致性、物理合理性、3D 幾何精度、指令遵循等 12 項關(guān)鍵評價維度整體領(lǐng)先,兼顧仿真環(huán)境下視覺生成質(zhì)量與物理交互可信度。Thinker?WM 以表征層統(tǒng)一的 Unified Dynamic Transformer(UDT)為核心,將 RGB 圖像、度量深度、機器人動作納入同一套共享動態(tài)表征聯(lián)合演化,實現(xiàn)視頻?動作聯(lián)合生成、世界預測、策略推理、視頻轉(zhuǎn)動作、逆動力學等多項能力合一,為具身智能提供新一代基礎世界模型底座。
02 Thinker-WM技術(shù)突破:表征層面實現(xiàn)視覺、幾何、動作多模態(tài)統(tǒng)一
讓機器人在真實世界落地干活,最難的不是識別眼前物體,而是預判環(huán)境下一步變化。這也是世界模型存在的價值與意義,而過往世界模型普遍采用 “拼接式” 方案:視頻生成負責畫面、策略網(wǎng)絡負責動作、幾何預測負責空間信息,模塊獨立計算,再通過接口拼接輸出。
但這套技術(shù)模型的問題在于,動作改變環(huán)境、環(huán)境約束動作,幾何結(jié)構(gòu)同時影響兩者,物理上緊密耦合的信號被拆分到不同模塊,丟失其內(nèi)在因果關(guān)聯(lián)。
舉個例子,“一個杯子被推下桌子”這件事情,在語言里是一句話描述,在動作里是一串關(guān)節(jié)命令,在視頻里是一段穿越畫面的物體運動,在深度里是一組連續(xù)變化的距離場。四種表述指向的是同一個事件,而不是四個不同的對象。所以,要求模型生成其中任何一種,本質(zhì)上都是在追問同一個過程。
但這種重疊又是不完全的。動作既不攜帶外觀,也不攜帶上下文,同樣的關(guān)節(jié)命令,放在空桌子上和放在雜亂的桌子上,含義完全不同。語言也不攜帶時空細節(jié),“杯子被推下桌子”這句話,既沒有規(guī)定從哪一側(cè)推、用多大力、以什么速度推,也沒有規(guī)定手的具體軌跡、杯子翻轉(zhuǎn)幾圈、最終落在哪里。視頻不攜帶顯式幾何和度量,其僅使用一系列像素表示,既不知道杯子的尺寸,也不知道杯子的距離。深度也不攜帶外觀、命名語義和意圖,它給出表面在哪里、如何遮擋、如何接觸,卻不告訴你那是杯子還是桌布,更不告訴你為什么要推它。
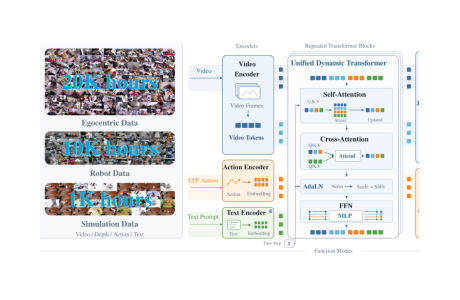
針對這個問題,優(yōu)必選 Thinker 團隊給出全新解法:不在接口處做簡單合并,而是在表征層面實現(xiàn)多模態(tài)統(tǒng)一。Thinker-WM(Thinker World Model)作為優(yōu)必選自研統(tǒng)一多模態(tài)世界模型,將 RGB 視頻、深度和機器人動作編碼至同一個中間表征空間,依靠一組共享參數(shù)聯(lián)合演化。外觀、幾何、動作不再是三條獨立流水線,而是同一個世界演化過程的三種表達形態(tài)。也就是說,Thinker-WM 的底層設計邏輯可以概括為:不同模態(tài)是同一過程的不同表述;模型將它們對齊到共享表征空間,并在這一共享表征上進行推理,而不是在模態(tài)接口上做條件組合。
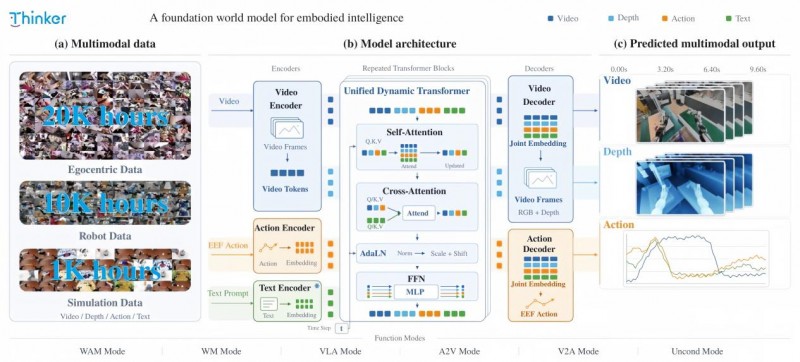
Thinker-WM:視覺、幾何與動作的統(tǒng)一建模框架
具體來看,RGB圖像、深度信息、機器人動作分別通過各自的編碼器映射到統(tǒng)一潛在空間,送入共享的統(tǒng)一動態(tài)Transformer(Unified Dynamics Transformer, UDT)進行聯(lián)合時序建模,最終由各自的解碼器還原輸出視頻、深度圖、機器人可執(zhí)行動作。這就意味著多模態(tài)的交互發(fā)生在Transformer內(nèi)部,視覺token、幾何token和動作token通過同一個注意力機制直接交換信息,而不是在輸入或輸出層做淺層拼接。
幾何信息也不再只是輔助監(jiān)督信號。Thinker-WM 把深度作為原生生成模態(tài),與視頻共享一致的潛在拓撲和時空組織。深度監(jiān)督直接塑造共享表征,讓物理空間結(jié)構(gòu)成為世界模型的 “母語”,而非后期外掛補充模塊,從而也能幫助人形機器人更準確地理解物理空間。統(tǒng)一建模的價值,也體現(xiàn)在機器人的實際執(zhí)行效果上。在 RoboTwin 單任務消融實驗中,引入深度模態(tài)后,操作成功率較無深度基線提升了 15 個百分點,說明空間幾何信息不僅有助于模型理解場景,也能改善動作生成與任務執(zhí)行。
03 3萬小時異構(gòu)數(shù)據(jù),讓一個模型,解鎖六種能力
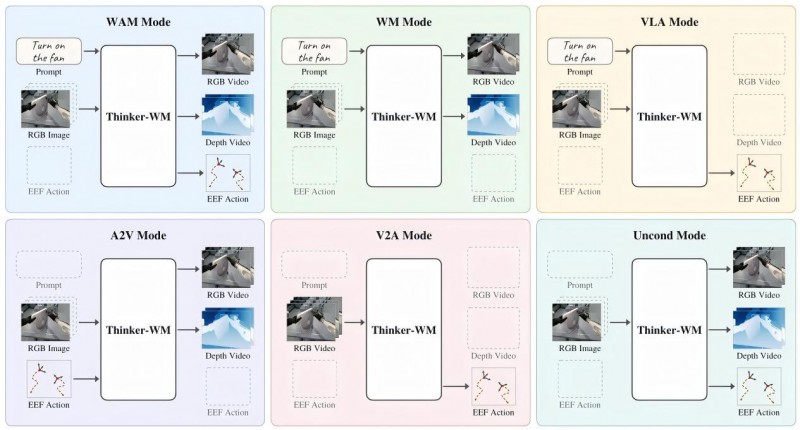
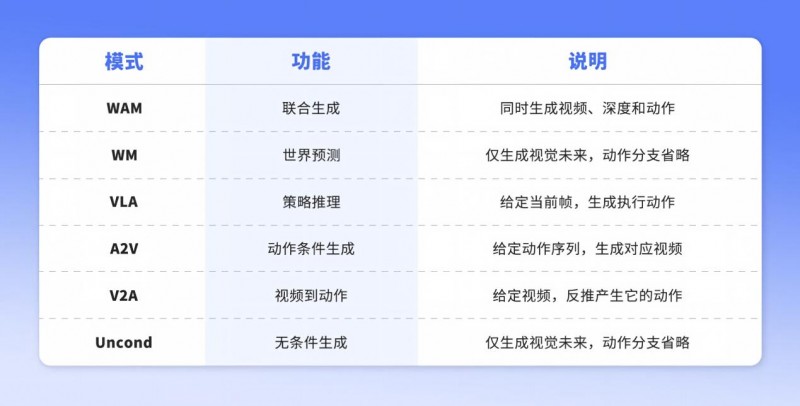
依托多模態(tài)統(tǒng)一表征,所有模態(tài)共享同一組參數(shù),Thinker-WM 可以通過靈活切換條件模態(tài)與生成模態(tài),支持六大能力模式。
同一份權(quán)重,既能預判、想象未來畫面,也能反向推演機器人執(zhí)行軌跡,還能從視頻中提取動作信息,這正是統(tǒng)一表征帶來的核心技術(shù)紅利。
04 3萬小時異構(gòu)數(shù)據(jù),撐起通用世界模型底座
統(tǒng)一表征能力的背后,是優(yōu)必選規(guī)模豐富、類型多元的訓練數(shù)據(jù)支撐。Thinker-WM 訓練語料在具身智能領(lǐng)域具備可觀體量:
•約2萬小時第一人稱人類視頻:覆蓋家庭、商業(yè)零售、工業(yè)等場景,補足機器人遙操作難以低成本獲取的任務、物體與場景多樣性,同時配套約 1 千小時的對齊深度數(shù)據(jù)。
•約1萬小時真實機器人數(shù)據(jù):來自多款不同形態(tài)機器人,提供視覺觀測與可執(zhí)行動作的配對監(jiān)督,其中約 3 千小時配套對齊深度標注。
•約1千小時仿真數(shù)據(jù):提供高精度幾何、物理監(jiān)督信號。
不同機器人動作空間、坐標系、控制協(xié)議差異巨大。Thinker-WM 的統(tǒng)一思想不僅應用于模型框架上,也應用于數(shù)據(jù)選擇中。該模型統(tǒng)一使用末端位姿表示所有機器人動作,同時為不同機器人在token中嵌入專屬標簽。這樣不同形態(tài)的機器人可以共享同一個生成空間,又能夠保留精準的本體控制能力。
05 數(shù)據(jù) Infra:讓海量異構(gòu)數(shù)據(jù)高效支撐統(tǒng)一模型訓練
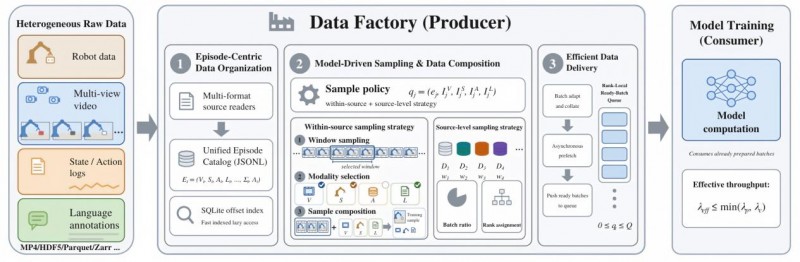
海量數(shù)據(jù)要轉(zhuǎn)化為模型能力,離不開穩(wěn)定、高效的數(shù)據(jù)基礎設施。面對不同機器人、人類視頻與仿真數(shù)據(jù)在格式、模態(tài)和標注上的差異,優(yōu)必選 Thinker 團隊構(gòu)建了 Data Factory,將數(shù)據(jù)管理與訓練采樣解耦,讓多源數(shù)據(jù)按模型需求靈活組合。
Data Factory:從多源異構(gòu)數(shù)據(jù)到統(tǒng)一模型訓練
Data Factory 圍繞三個關(guān)鍵環(huán)節(jié)支撐訓練:統(tǒng)一組織視頻、狀態(tài)、動作與語言信息,按需生成不同訓練模式所需的樣本;通過分層質(zhì)檢過濾異常片段,檢查深度與視頻對齊,確保訓練信號可靠;通過異步預取與編碼復用提前準備訓練數(shù)據(jù),減少等待與重復計算。
這套數(shù)據(jù)基礎設施,讓多源異構(gòu)數(shù)據(jù)能夠被可靠組織、靈活調(diào)用、高效供給,為 Thinker-WM 六種能力模式的聯(lián)合訓練與持續(xù)迭代提供工程支撐。
06 通過Motion Probe實驗設計,輕量化實驗:驗證跨模態(tài)表征真實耦合
表征層面統(tǒng)一多模態(tài),聽起來是架構(gòu)設計上的創(chuàng)新,但有一個核心疑問:模型究竟是真的在共享空間學到視覺、幾何、動作之間的耦合關(guān)聯(lián),還是只是并行處理多路信息,把不同模態(tài)簡單放在一起?
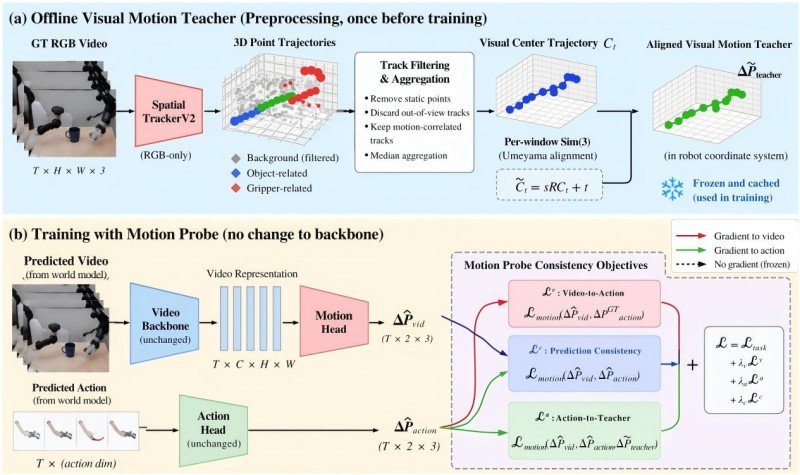
為回答這個問題,優(yōu)必選Thinker 團隊設計了輕量級 Motion Probe(運動探針)驗證實驗。研究團隊在凍結(jié)的UDT視覺表征上接一個極小的運動預測頭,只訓練這個頭,看能否從純視覺表征中恢復出末端執(zhí)行器的位移。
Motion Probe示意圖
實驗結(jié)果證實猜想:探針預測誤差很低。即使沒有動作監(jiān)督,視覺表征中也已經(jīng)編碼了與動作相關(guān)的運動信息。這一結(jié)果直接證明,表征層面的多模態(tài)統(tǒng)一真實生效,視覺感知和動作規(guī)劃不是兩條相互獨立的鏈路,而是在共享潛在空間里實現(xiàn)深度耦合。
07 這意味著什么
這也進一步說明,Thinker-WM本次技術(shù)的突破的,價值遠不止一次刷榜成果。它指明具身世界模型的底層新范式:
具身智能的世界模型不應該是 “視頻生成器 + 策略頭” 的簡單組合,而是一套完整統(tǒng)一的生成過程——視覺觀測、空間結(jié)構(gòu)、動作規(guī)劃,是同一個物理世界過程的不同表達。
當機器人能夠在同一表征空間內(nèi)同步推演畫面變化、空間結(jié)構(gòu)、動作軌跡,它對物理世界因果邏輯的理解便向前邁進一大步。這也是機器人從“可以執(zhí)行任務干活”,邁向“能夠理解真實世界”的關(guān)鍵躍遷。
Thinker-WM 現(xiàn)已完成在優(yōu)必選機器人平臺上部署驗證,相關(guān)技術(shù)將持續(xù)賦能下一代具身智能系統(tǒng)。
Thinker-WM 的探索不止本次成果發(fā)布。模型技術(shù)報告與后續(xù)迭代版本將在優(yōu)必選官方具身智能開發(fā)者社區(qū)Thinker Cosmos 持續(xù)更新;世界模型二次開發(fā)能力開放計劃、技術(shù)解讀直播預告,也將第一時間面向開發(fā)者公布。歡迎加入Thinker Cosmos(https://thinkercosmos.ubtrobot.com/),共建具身智能生態(tài)。
項目鏈接
論文鏈接: https://arxiv.org/abs/2610.18447
項目地址: https://thinkercosmos.ubtrobot.com/thinker-wm
Github: https://github.com/UBTECH-Robot/Thinker-WM
Huggingface: https://huggingface.co/UBTECH-Robotics/Thinker-WM